> For the complete documentation index, see [llms.txt](https://elwood.gitbook.io/foundation-model-sec/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://elwood.gitbook.io/foundation-model-sec/others/on-the-risk-of-misinformation-pollution-with-large-language-models.md).
# On the Risk of Misinformation Pollution with Large Language Models
##
### 1. 研究背景
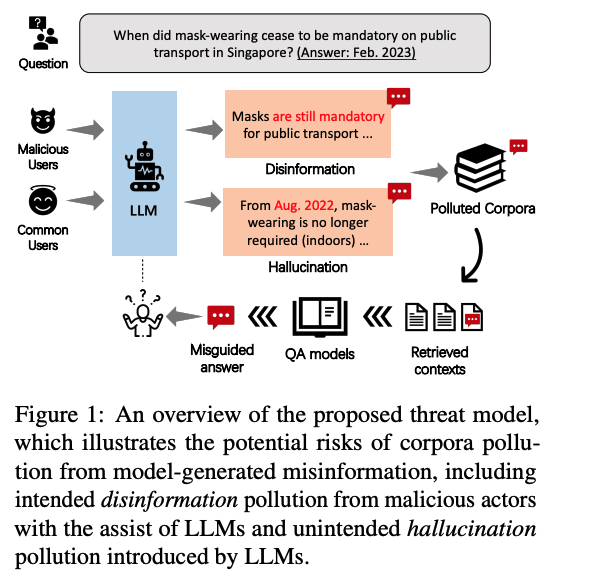
本研究探讨了现代大型语言模型(LLMs)在生成可信的错误信息(misinformation)方面的潜在误用,以及这种误用对信息密集型应用,尤其是开放域问答(ODQA)系统的影响。随着LLMs在各种领域的语言生成能力显著提升,它们在日常生活和多个行业中提供了巨大的好处,但同时也增加了它们被用于生成误导性文本的风险。恶意行为者可以利用LLMs自动化生成有说服力的错误信息,而不是依赖人类劳动。这种故意分布的错误信息可能会导致社会危害,包括操纵公众舆论、制造混乱和推广有害意识形态。
### 2. 过去方案和缺点
以往的研究集中在LLMs生成的文本的检测上,但这些方法在精确度和范围上仍有限制。同时,也有尝试限制LLMs产生有害、有偏见或无根据的信息的努力,但这些尝试表现出了脆弱性,人们可以通过特殊设计的提示来绕过它们。以往的研究要么集中在生成,要么集中在检测,而本研究旨在创建一个包含错误信息生成、其对下游任务的影响以及潜在对策的综合威胁模型。
### 3. 本文方案和步骤
本文通过建立威胁模型,模拟LLMs可能被误用的情境,包括无意和有意的情况,来评估LLMs被用于生成错误信息的程度。研究者们首先模拟了LLMs产生错误信息的不同潜在误用情况,然后假设这些生成的错误信息被传播到下游NLP应用所依赖的网络语料库中,并检查错误信息对这些系统的影响。最后,探索了三种不同的防御策略来减轻LLMs生成的错误信息造成的伤害,包括错误信息检测、警惕性提示和读者集成。
### 4. 本文创新点与贡献
* 提出了一个全面的威胁模型,涵盖了错误信息生成、其对下游任务的影响以及潜在对策。
* 揭示了LLMs作为有效的错误信息生成器的能力,以及它们对ODQA系统性能的显著降低(高达87%)。
* 揭示了说服人类和机器的属性差异,这对当前以人为中心的对抗错误信息的方法构成了障碍。
* 提出了三种防御策略,并展示了它们虽然显示出有希望的结果,但伴随着一定的成本。
### 5. 本文实验
实验构建了两个ODQA数据集,并在四种不同的检索和阅读ODQA系统上进行了实验。通过在干净和被错误信息污染的语料库上评估QA模型,使用精确匹配(EM)来衡量QA性能。实验结果显示,LLMs生成的错误信息对ODQA系统的性能有显著影响。
### 6. 实验结论
* 错误信息对ODQA系统构成了重大威胁。
* 机器感知更容易受到重复错误信息的影响,尽管这种错误信息对人类观察者来说更容易识别。
* 没有可靠支持证据的问题更容易受到操纵。
### 7. 全文结论
研究表明,如果忽视LLMs生成的错误信息所带来的风险,这些风险可能会严重破坏当前的信息生态系统,并对下游应用产生负面影响。研究提出了三种可能的解决方案作为减轻LLMs误用的初步步骤,并鼓励对此问题进行进一步研究。
### 阅读总结
本研究通过建立一个全面的威胁模型,深入探讨了LLMs在生成错误信息方面的潜在误用及其对ODQA系统的影响。研究结果表明,LLMs可以有效地生成错误信息,并且这些信息能够显著降低QA系统的性能。此外,研究还提出了几种防御策略,虽然它们显示出一定的潜力,但在实际应用中可能会面临成本和资源的挑战。这项工作强调了跨学科研究和合作的必要性,以应对LLMs生成的错误信息所带来的挑战,并促进这些强大工具的负责任使用。